pf и ipfw одновременно — последовательность обработки пакетов

Вводная информация. Зачем нужны два файрвола.

Так исторически сложилось, что на ряде FreeBSD-серверов в конторе мы используем одновременно два файрвола. Иногда это связано с ограничением функционала, иногда — с багами в работе конкретного файрвола.

Например, на pf гораздо проще организовать NAT в несколько внешних IP, причём разбрасывать клиентов по IP он может разными алгоритмами. Мы используем source hash — когда файрвол выбирает IP, в который будет NATиться конкретный пользователь, исходя из IP-адреса этого пользователя. Т. е. в рамках одной PPPoE-сессии конкретный клиент всегда будет ходить с одного и того же IP.

Или, например, у pf есть возможность ограничивать количество соединений в секунду. Так мы блокируем активность ботов по рассылке спама на пользовательских компах — число соединений с одного пользовательского IP на любой 25-ый порт в интернете ограничено не более чем 10 соединений в 30 секунд. Если пользователь превышает этот лимит — его IP заносится в табличку и ему доступ к любому 25-му порту блокируется на 1 час. По истечении часа скрипт очищает эту табличку, и всё начинается заново.

Но есть у pf и проблемы. Например, у него до сих пор нет connection tracker'a для протокола PPTP. Что делает невозможным использование пользователями PPTP-туннелей. Точнее, не так. Пользователь может юзать PPTP-туннель, но это доступно будет только одному пользователю на конкретном BRAS'e. Соответственно — кто раньше туннель установил, того и тапки. У остальных туннели работать уже не будут — файрвол не в состоянии отличить идущие внутри туннеля пакеты и правильно раскидать их по пользователям. Поэтому задачу NAT'a PPTP и GRE трафика мы решаем с помощью IPFW.

Также в процессе эксплуатации в файрволе pf выявилось несколько багов. Про один я уже писал, про второй написать пока только планирую. Коротко — суть бага в том, что при использовании в pf правила route-to для пакетов, пришедших через PPPoE и прошедших NAT криво просчитывается контрольная сумма. Старший и младший байт контрольной суммы меняются местами (т. е. если сумма должна быть 0xABDC, то в результирующем пакете после обработки его PF контрольная сумма проставлялась 0xCDAB), и получатель такого пакета его просто молча дропает. Поэтому этот функционал также пришлось запилить на IPFW., про второй написать пока только планирую. Коротко — суть бага в том, что при использовании в pf правила route-to для пакетов, пришедших через PPPoE и прошедших NAT криво просчитывается контрольная сумма. Старший и младший байт контрольной суммы меняются местами (т. е. если сумма должна быть 0xABDC, то в результирующем пакете после обработки его PF контрольная сумма проставлялась 0xCDAB), и получатель такого пакета его просто молча дропает. Поэтому этот функционал также пришлось запилить на IPFW.

К чему я это всё?

А вот к чему. Когда используешь два файрвола одновременно, то возникает вопрос последовательности обработки пакетов файрволами, чтобы правила одного файрвола не мешали работать правилам другого файрвола. Поэтому в какой-то момент пришлось разбираться с тем, как всё это работает.

Как это работает

Было бы логично предположить, что последовательность обработки пакетов двумя файрволами будет зависеть от последовательности загрузки соответствующих модулей ядра. Но, как говорит наш школьный физик: «Мысль хорошая. Но неправильная». На самом деле, последовательность обработки будет зависеть от того, в какой последовательности файрволы встраивают свои обработчики (hooks) в цепочки обработчиков фреймворка pfil (подробности можно почитать в man 9 pfil). Эти цепочки представляют собой очереди, отдельно для обработки входящих пакетов, и отдельно — для исходящих.). Эти цепочки представляют собой очереди, отдельно для обработки входящих пакетов, и отдельно — для исходящих.

Причём каждый файрвол вставляет свой обработчик в цепочку в разные моменты своей загрузки. IPFW вставляет сразу при загрузке модуля, а pf при загрузке модуля ничего не делает, и встраивает обработчик только когда мы говорим pfctl -e, т. е. собственно включаем файрвол., т. е. собственно включаем файрвол.

Соответственно, если посмотреть на rcoderd, то файрволы грузятся в следующем порядке:, то файрволы грузятся в следующем порядке:

# rcorder /etc/rc.d/* |  grep -nE '/i?pfw?$'
41:/etc/rc.d/pf
57:/etc/rc.d/ipfw

Соответственно, в этом случае обработка будет происходить так:
Как следует из картинки, при стандартной схеме загрузки файрволов для входящих пакетов первым будет отрабатывать IPFW, а для  первым будет отрабатывать IPFW, а для исходящих первым будет работать PF. первым будет работать PF.

Также нужно понимать, что если вы перезапустите файрвол pf, то последовательность обработки поменяется, так как в момент останова pf уберёт обработчики из очереди, а при запуске опять вставит их, но уже вот так:
Соответственно, входящие пакеты первым будут попадать в PF, а исходящие — сначала обрабатываться IPFW.

Так что нужно понимать, что и в каком порядке обрабатывается, где у вас выполняется NAT (и для каких пакетов — входящих или исходящих), и учитывать это взаимное влияние при написании конфигурации файрволов.

При желании, можно изменить порядок начальной инициализации файрволов таким образом, чтобы IPFW стартовал первым. Для этого не обязательно править rcorder, достаточно в /, достаточно в /boot/loader.conf вписать загрузку модуля IPFW. Пользуясь тем, что IPFW ставит свои обработчики при загрузке модуля, получится, что IPFW будет стартовать первым. вписать загрузку модуля IPFW. Пользуясь тем, что IPFW ставит свои обработчики при загрузке модуля, получится, что IPFW будет стартовать первым.
Время, вперёд!

Коллега недавно наткнулся на забавный косяк. Прописывает он задание в кроне, а оно не отрабатывает. Он уже и так, и так, и всё проверил — в логах запись об очередном запуске других (периодических) заданий крона есть, а его задание не отрабатывает.

Полезли смотреть всей толпой. Выявили, что в логах факт отработки крона логируется с указанием времени, на час опережающем текущее. Т. е. если, например, выполнить date, то получаем 17 часов, а крон в лог пишет, что запустился в 18 часов. Вспомнили, что мы этот сервак не перезагружали после обновления time zone data. Я сделал , то получаем 17 часов, а крон в лог пишет, что запустился в 18 часов. Вспомнили, что мы этот сервак не перезагружали после обновления time zone data. Я сделал service syslogd restart. Смотрю в логи — ну, вроде как факт очередного редактирования crontab записался с правильным временем . Должно задание отработать. Однако нифига :-) В логах стало вот так:. Смотрю в логи — ну, вроде как факт очередного редактирования crontab записался с правильным временем . Должно задание отработать. Однако нифига :-) В логах стало вот так:

Oct 14 17:41:13 vpn2-lesnoy crontab[63631]: (root) BEGIN EDIT (root)
Oct 14 17:41:34 vpn2 crontab[63631]: (root) REPLACE (root)
Oct 14 17:41:35 vpn2 crontab[63631]: (root) END EDIT (root)
Oct 14 17:41:46 vpn2 crontab[63646]: (root) BEGIN EDIT (root)
Oct 14 17:41:52 vpn2 crontab[63646]: (root) END EDIT (root)
Oct 14 18:42:00 vpn2 /usr/sbin/cron[992]: (root) RELOAD (tabs/root)
Oct 14 17:42:34 vpn2 crontab[63677]: (root) LIST (root)
Oct 14 18:44:00 vpn2 /usr/sbin/cron[63721]: (operator) CMD (/usr/libexec/save-entropy)
Oct 14 18:45:00 vpn2 /usr/sbin/cron[63763]: (root) CMD (/usr/libexec/atrun)

Т. е. время скачет очень внезапно :-) Перезапуск крона этот вопрос решил, и время везде синхронизировалось. Т. е. задание не отрабатывало потому, что коллега устанавливал срабатывание задания на 17 часов, а крон считал, что уже 18 часов.

Баг в файрволе pf

Предисловие

В конторе мы вынужденно используем FreeBSD 9.3 на BRAS'ах. Вызвано это тем, что на 10-ой фре есть какой-то косяк с mpd (у нас с его помощью PPPoE-соединения от клиентов обслуживаются). И mpd периодически виснет при значительном изменении числа подключений. Т. е. когда много клиентов одновременно подключается или отключается, mpd зависает в состоянии umtxn. Я писал по этому поводу в уже открытый PR, но движухи по нему нет.. Я писал по этому поводу в уже открытый PR, но движухи по нему нет.

О проблеме

Но речь не об этом. В общем, на фре 9.3 в файрволе pf обнаружился занятный баг. Баг относится к работе NAT на pf. Проявляется так:

  1. Клиент шлёт через NAT запрос на какой-то сервер в интернете;
  2. Сервер ему отвечает;
  3. Но за время ответа у клиента этот порт, с которого он отправлял свой запрос, почему-то закрылся;
  4. Клиент примет пакет от сервера и ответит серверу ICMP пакетом с типом port unreachable

Тут-то и проявляется баг — pf'овский NAT некорректно натит этот ответный ICMP-пакет, и в итоге с внешнего интерфейса улетает ICMP-пакет с серым SRC IP клиента и белым DST IP того сервера, куда этот пакет должен быть доставлен.

Т. е. допустим, у вас адрес NAT-интерфейса — 1.1.1.1, адрес сервера в интернете 2.2.2.2. И адрес клиента 192.168.0.1. В итоге с ВНЕШНЕГО интерфейса NAT'a улетит пакет с адреса 192.168.0.1 на адрес 2.2.2.2. Т. е. трансляции адреса клиента во внешний адрес NAT (1.1.1.1) не произойдёт.

Кровавые подробности

Если быть совсем точным, то трансляция ICMP-пакета таки происходит. Но не везде и не до конца :-)

Немного теории

ICMP-пакеты подразделяются на несколько типов. Причём в каждом типе есть ещё несколько подтипов. В данном случае клиент генерирует пакет типа 3 «destination unreachable». И подтипа тоже 3 — «port unreacable». Подробности можно почитать в man icmp, там есть табличка с типами и подтипами (подтипы называются codes, коды). В пакет типа port unreacahble клиент вкладывает заголовок того пакета, который вызвал генерацию сообщения ICMP «port unrecahable» (назовём для краткости такой пакет «пакетом-инициатором»). Ну, чтобы сервер, получивший от клиента ICMP destination unreachable понимал, на какой конкретно его пакет клиент ответил, что порт недоступен. И вот расследование показало, что как раз этот заголовок, пакета-инициатора транслируется файрволом нормально. Но сам ICMP-пакет — нет.

Суровая практическая реальность

Итак, мы приняли, что локальный IP клиента у нас 192.168.0.1, а внешний IP, в который NAT'ится клиентский трафик — 1.1.1.1. Таким образом, получается примерно такой формат ICMP-пакета от клиента обратно на сервер 2.2.2.2 (до трансляции):

Заголовок ICMP SRC IP: 192.168.0.1 DST IP: 2.2.2.2
Заголовок пакета-инициатора SRC IP: 2.2.2.2 port 80 DST IP: 192.168.0.1 port 12345

То есть, клиент со своего адреса 192.168.0.1 оповещает сервер 2.2.2.2, что типа, «бро, ты мне отправил пакет со своего IP 2.2.2.2 и порта 80 на мой адрес 192.168.0.1 и порт 12345. Ну так вот, довожу до твоего сведения, что этот порт у меня закрыт».

После трансляции через NAT пакет должен модифицироваться следующим образом:

Заголовок ICMP SRC IP: 1.1.1.1 DST IP: 2.2.2.2
Заголовок пакета-инициатора SRC IP: 2.2.2.2 port 80 DST IP: 1.1.1.1 port 54321

То есть, NAT уже от своего имени проговаривает серверу 2.2.2.2: «бро, ты мне отправил пакет со своего IP 2.2.2.2 и порта 80 на мой адрес 1.1.1.1 и порт 54321. Ну так вот, довожу до твоего сведения, что этот порт у меня закрыт».

Обращаю внимание, что порт на клиентской стороне ДО и ПОСЛЕ трансляции могут отличаться. Т. е. то, что у клиента слушает на порту 12345, на NAT'е будет на порту 54321 (ну, или на любом другой, который будет свободен на момент установки соединения клиентом, и который NAT выберет для трансляции). Ну это так, для сведения, сейчас это роли не играет.

Так вот, из-за бага в pf пакет транслируется следующим образом:

Заголовок ICMP SRC IP: 192.168.0.1 DST IP: 2.2.2.2
Заголовок пакета-инициатора SRC IP: 2.2.2.2 port 80 DST IP: 1.1.1.1 port 54321

Т. е. NAT в pf транслирует только заголовок пакета-инициатора, идущий нагрузкой в ICMP-пакете типа «destination unreachable», но не транслирует заголовок самого ICMP-пакета.

Заключение

Написал сообщение в рассылку freebsd-net. Там товарищ Kristof Provost попросил проверить, есть ли такое же поведение в -CURRENT, и если да, то он посмотрит, в чём там проблема. Ну, соберу -CURRENT на досуге, попробую.

А, кстати, ещё один момент. pf не только некорректно натит такие пакеты, но и также не может блокировать этот трафик. Т. е. правило вида

block out quick inet proto icmp from 192.168.0.0/24 to any

тоже не работает для таких пакетов. Похоже, pf анализирует только содержащийся в нагрузке заголовок пакета-инициатора, а не самого ICMP-пакета.

UPDATE

Собрал -CURRENT, проверил. Это поведение полностью повторяется и в -CURRENT. Нарисовал багрепорт по этому поводу, авось когда-нибудь починят. На текущий момент подобный пытающийся улететь наружу трафик блокируется с помощью IPFW.

Виртуализация FreeBSD на Hyper-V

Решил побаловаться с SCVMM 2012 R2, посмотреть, что это такое и с чем его едят. Развернул два хоста с Hyper-V Server 2012 R2, и один хост с Win2012 R2 под общее хранилище кластера виртуализации.

Первым делом поставил в виртуалку фрю, чтобы посмотреть, как оно себя там чувствует. Оказалось, что чувствует фря себя там относительно неплохо. Прямо из коробки есть синтетический сетевой, и синтетический же дисковый адаптер. Правда, с последним возник касичок, о чём и пойдёт речь ниже.

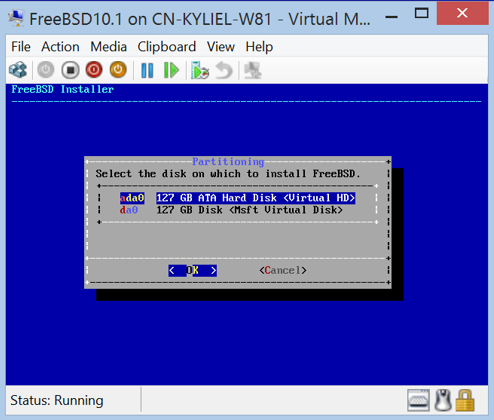
Суть косяка в том, что фря видит ДВА диска там, где по факту он всего один. На этапе установки это выглядит так:

Я выбрал при установке da0, и поставил систему туда, и всё отлично заработало. Но решил разобраться, в чём тут дело. Первое предположение было, что фря видит два диска из-за проблем в драйвере. И ada0 — это эмулируемый дисковый контроллер, а da0 — синтетический. Гуглинг ничего не показал, кроме указаний на статью в MSDN. Но там никакого внимания этой проблеме не уделено, просто скриншот (это как раз он выше) представлен, и всё. И пользователь в комментариях задаёт вопрос, типа, «why attached virtual disk to guest is visible twice? It's visiblle as ada0 and da0». Или, иными словами, а почему диск виден дважды под разными именами? Но ответа на этот вопрос не последовало.. Но там никакого внимания этой проблеме не уделено, просто скриншот (это как раз он выше) представлен, и всё. И пользователь в комментариях задаёт вопрос, типа, «why attached virtual disk to guest is visible twice? It's visiblle as ada0 and da0». Или, иными словами, а почему диск виден дважды под разными именами? Но ответа на этот вопрос не последовало.

Больше никакой информации найти не удалось, поэтому я решил написать команде разработчиков в Microsoft, которые пилят поддержку гостевых компонентов Hyper-V во фре. Написал безо всякой надежды на ответ, однако на следующий день мне ответили.

В общем, по итогам общения выяснилось, что действительно, два диска представляют по сути один диск, но видимый через разные дисковые контроллеры. ada0 — это эмулируемый контроллер, da0 — синтетический. Разработчики рекомендовали использовать da0, так как будет выше производительность и ниже нагрузка на процессор. И можно слегка поправить исходники соответствующего модуля, чтобы система перестала видеть диск ada0 вообще, и остался только da0. Для этого нужно сделать следующее: в файле /usr/src/sys/dev/hyperv/stordisengage/hv_ata_pci_disengage.c необходимо найти функцию необходимо найти функцию v_ata_pci_probe(), и заменить в ней возвращаемое значение (return value) с BUS_PROBE_DEFAULT на BUS_PROBE_VENDOR. После этого пересобрать и установить ядро. Я проделал это, и проблема исчезла., и заменить в ней возвращаемое значение (return value) с BUS_PROBE_DEFAULT на BUS_PROBE_VENDOR. После этого пересобрать и установить ядро. Я проделал это, и проблема исчезла.

Также был затронут вопрос про KVP daemon. Это процесс, который умеет из гостевой фри общаться с гипервизором, и принимать/передавать туда-сюда key-values pairs. Т. е. какие-то параметры конфигурации. В частности, он используется для того, чтобы в Hyper-V manager можно было видеть IP-адрес, который имеет гостевая фря. И, по слухам, также может получать статические IP из пула, назначаемого из SCVMM, и прописывать его в гостевую систему. Но это я ещё не проверял, поэтому не знаю.

В общем, с KVP (процесс hv_kvp_daemon) тоже проблемка — он стартует только один раз после установки системы, а потом отказывается. Я порылся, и выяснил, что при запуске hv_kvp_daemon пытается создавать директорию /var/db/hyperv/pool. И если эта директория уже существует, (и следовательно, создать её не удаётся), то hv_kvp_daemon не запускается. Налицо просто некорректная обработка ошибки при попытке создания каталога. Т. е. вместо проверки на существование каталога делается попытка создания, и если она неудачная, то fail. Удаление каталога руками проблему решает — hv_kvp_daemon запускается. Непонятно, почему в системе нет стартового скрипта для этого демона, и его нужно запускать ручками. Возможно, считается, что демон ещё не доведён до ума, поэтому и стартового скрипта нет. В принципе, эту проблему с создание каталога можно обойти в стартовом скрипте — удалять каталог после остановки демона, и проверять каталог на существование при старте, и если он есть — опять таки, удаляем, hv_kvp_daemon его создаст себе сам.. И если эта директория уже существует, (и следовательно, создать её не удаётся), то hv_kvp_daemon не запускается. Налицо просто некорректная обработка ошибки при попытке создания каталога. Т. е. вместо проверки на существование каталога делается попытка создания, и если она неудачная, то fail. Удаление каталога руками проблему решает — hv_kvp_daemon запускается. Непонятно, почему в системе нет стартового скрипта для этого демона, и его нужно запускать ручками. Возможно, считается, что демон ещё не доведён до ума, поэтому и стартового скрипта нет. В принципе, эту проблему с создание каталога можно обойти в стартовом скрипте — удалять каталог после остановки демона, и проверять каталог на существование при старте, и если он есть — опять таки, удаляем, hv_kvp_daemon его создаст себе сам.

Мораль: фрю вполне можно использовать в качестве гостевой ОС внутри Hyper-V. Я вижу в коммитах фрёвых исходников, что какая-то работа потихоньку, поддержка Hyper-V во фре допиливается, медленно, но верно. Остаётся дождаться только работы динамической памяти в гостевой фре, и можно совершенно смело гостевать фрю на Hyper-V. Сейчас оно всё работает — сетка и диски видны из коробки (на фре 10.1), крутится довольно стабильно. Правда, я нагрузки большой не давал, но в рамках той нагрузки, что есть, всё работает.

Samba и ZFS: расширенные ACL и их правка из винды

Постановка задачи

Возникла необходимость запилить файл-сервер на Samba и дать ряду пользователей возможность рулить правами доступа на отдельные каталоги. Система — FreeBSD 10.1 amd64, файло будет лежать на ZFS. Версия Samba — 3.6.24.

Исследование задачи показало, что стандартными правами Unix (aka «Unix mode») тут не обойтись. Надо использовать расширенный набор ACL. Например, нужно, чтобы к каталогу имели доступ более одной группы, но не все группы (т. е. разрешения для other тут не прокатит). Ну и на некоторые папки нужно давать доступ не отдельным группам, а прямо отдельным пользователям.

Общие сведения

По дефолту, как известно, в юниксах права на файлы и каталоги расставляются по схеме «ugo» — «user-group-other»). Во фре с помощью утилиты setfacl можно задавать права по двум схемам — POSIX 1.E и NFSv4, в зависимости от файловой системы. По факту же POSIX 1.E  здесь сильно редуцирован — до этой самой схемы ugo. Тогда как в действительности POSIX 1.E слегка побогаче (подробности можно вкурить можно задавать права по двум схемам — POSIX 1.E и NFSv4, в зависимости от файловой системы. По факту же POSIX 1.E  здесь сильно редуцирован — до этой самой схемы ugo. Тогда как в действительности POSIX 1.E слегка побогаче (подробности можно вкурить отсюда). Как гласит ). Как гласит man setfacl::

access permissions

Что в переводе означает: «Поля с разрешениями содержат букавки r, w или x для чтения, записи или выполнения соответственно».

Но это всё нам не очень интересно, так как у нас ZFS, а на ZFS ACL по умолчанию соответствуют схеме NFSv4.

Тюнинг ZFS

Поэтому прежде чем заюзать всю эту красоту с крутыми ACL на ZFS, необходимо ZFS слегка потюнить. А именно, проделать такое:

zfs set aclmode=passthrough storage0

zfs set aclinherit=passtrhough storage0 В данном случае storage0 — это имя моего ZFS-пула — это имя моего ZFS-пула

zfs set aclmode=passthrough делает так, что если над папкой выполняется chmod, то при наличии у папки расширенных ACEs (access control entries) (расширенные — это те, которые помимо стандартных @owner, @group, @other), то эти ACL при этом НЕ ИЗМЕНЯЮТСЯ. делает так, что если над папкой выполняется chmod, то при наличии у папки расширенных ACEs (access control entries) (расширенные — это те, которые помимо стандартных @owner, @group, @other), то эти ACL при этом НЕ ИЗМЕНЯЮТСЯ.

Также там есть режимы:

  • discard — т. е. никаких ACL сверх стандартного unix mode сохраняться не будет; — т. е. никаких ACL сверх стандартного unix mode сохраняться не будет;
  • groupmask — новые ACL по итогу будут выставляться так, чтобы они не превышали тех, которые принадлежат @group, за исключением случая, если UID пользователя в ACL совпадает с UID владельца каталога или файла. В этом случае выставляются права не выше, чем у владельца файла. Пока даже не могу предположить, для чего такой режим может использоваться. — новые ACL по итогу будут выставляться так, чтобы они не превышали тех, которые принадлежат @group, за исключением случая, если UID пользователя в ACL совпадает с UID владельца каталога или файла. В этом случае выставляются права не выше, чем у владельца файла. Пока даже не могу предположить, для чего такой режим может использоваться.

Если коротко, то zfs set aclinherit=passthrough необходима, для того, чтобы ACL свежесоздаваемых файлов и каталогов наследовались от каталога, в котором они создаются. Есть ещё режим passthrough-x — то же самое, что passthrough, только бит «executable» выставляется только в случае, если создающее файл приложение явным образом требует у создаваемого файла выставить бит «executable». Подробности можно необходима, для того, чтобы ACL свежесоздаваемых файлов и каталогов наследовались от каталога, в котором они создаются. Есть ещё режим passthrough-x — то же самое, что passthrough, только бит «executable» выставляется только в случае, если создающее файл приложение явным образом требует у создаваемого файла выставить бит «executable». Подробности можно вкурить тут..

Правка прав доступа из винды

В условиях задачи была заявлена необходимость дать некоему пользователю возможность управления доступом на каталоги в расшаренных папках. Причём от тонкостей командной строки пользователь бесконечно далёк, но может пользоваться виндовым диалогом прав доступа (который в свойствах папок или файлов в винде на вкладке «Безопасность» находится).

Поэтому устанавливаем владельца всех папок в шаре на определённый аккаунт, который будет админским. Допустим, это будет учётка i.ivanov. Тогда делаем так:

find /mnt/storage0/share -type d -exec setfacl -m u:i.ivanov:full_set:fd:allow {} \;

find /mnt/storage0/share -type f -exec setfacl -m u:i.ivanov:full_set:allow {} \; Первый find выставляет права full_set (это сокращение на «Полный доступ») на каталоги, а второй find — на файлы. Два find необходимы потому, что в синтаксисе команды setfacl при установке прав на каталог есть ещё модификатор «:fd:». Он означает, что права нижележащих каталогов должны наследоваться от вышестоящих. У файлов такого модификатора нет (т. е. в ACL на файлы он не предусмотрен). Если попытаться задать права на файл в формате при установке прав на каталог есть ещё модификатор «:fd:». Он означает, что права нижележащих каталогов должны наследоваться от вышестоящих. У файлов такого модификатора нет (т. е. в ACL на файлы он не предусмотрен). Если попытаться задать права на файл в формате -m u:i.ivanov:full_set:fd:allow, то , то setfacl выдаст ошибку. выдаст ошибку.

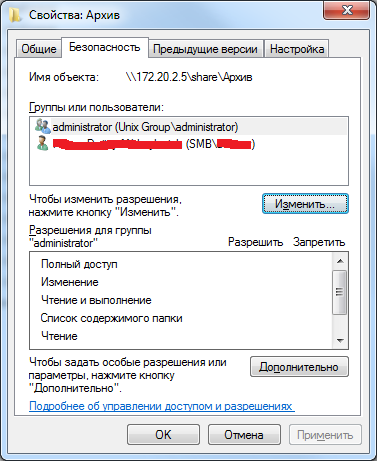
Далее нам надо замапить группы Unix на группы в Samba. Если этого не сделать, то в диалоге «Безопасность» на винде будут видны пользователи файл-сервера (их отдаёт Самба), но не будет видно групп. Если же назначить группу руками через setfacl, то группа будет видна как «Unix Group\unixgroup»:

Но из виндового диалога добавить юниксовые группы не удастся — их там просто не видно. Чтобы они стали видны в этом диалоге, необходимы дополнительные телодвижения. Допустим, у нас есть на файл-сервере группы buhgalteria, common, engineers и bosses. Чтобы эти группы стали видны на Windows, делаем так:

net groupmap add unixgroup=buhgalteria type=local ntgroup="Бухгалтерия"

net groupmap add unixgroup=common type=local ntgroup="Все юзеры"

net groupmap add unixgroup=engineers type=local ntgroup="Инженеры"

net groupmap add unixgroup=bosses type=local ntgroup="Начальство" И после этого в диалоге добавления прав будут присутствовать соответствующие группы. Обращаю внимание, что если имена групп NT у вас на русском, то добавлять их в маппинг надо в кодировке UTF-8.

Настройка собственно Samba

Отключаем маппинг атрибутов DOS в файлах на exec-биты и включаем хранение атрибутов DOS в виде дополнительных файлов с атрибутами. Это не обязательно, просто меня бесит, что свеже-создаваемые в SMB-шарах файлы имеют атрибут «исполняемых» при просмотре прямо в консоли сервера. Это криво и несекурно — мало ли, кто там чо зальёт.

# Disable mapping DOS bits
    map hidden = no
    map system = no
    map archive = no

# Use extended attributes to store file modes
    store dos attributes = yes

Отключаем unix extensions (они нужны для того, чтобы Самба могла работать с расширениями CIFS от HP — там можно реализовывать симлинки, хардлинки и прочее. Эти расширения могут использовать разные другие SMB-клиенты, но винда их не поддерживает. Клиенты у нас в основном на винде — поэтому unix extensions нам ни к чему. Также выставляем параметры наследования и режима обработки ACL:

# Use inherited ACLs for directories
    nt acl support = yes
    inherit acls = yes
    inherit owner = yes
    inherit permissions = yes
    map acl inherit = yes
    unix extensions = no
  • nt acl support — включает режим маппинга NT-like ACL на ACL файловой системы; — включает режим маппинга NT-like ACL на ACL файловой системы;
  • inherit acls — включает режим наследования ACL от каталога, в котором создаются новые файлы и каталоги. Без этого параметра дополнительные ACL не будут наследоваться для новых файлов, будут наследоваться только unix mode разрешения;
  • inherit owner — включает режим наследования владельца каталога, в котором создаётся файл. Без этого параметра владельцем будет становиться тот пользователь, который этот файл создаёт. В рамках нашей задачи наследование требуется, поэтому включаем;
  • inherit permissions — включает наследование unix mode разрешений;
  • map acl inherit — Самба будет мапить флаги «наследовать права от родительского каталога» в NT acls на файловую систему.

И в настройках шары делаем так:

    vfs objects = zfsacl #включаем модуль zfsacl, чтобы самба мог работать с ACL на ZFS
    nfs4:acedup = merge # сливать в одну запись дублирующиеся ACE
    nfs4:chown = yes # разрешаем менять влалельца файлов

На этом, собственно, всё. А теперь — дискотека! :-)

Источники

Samba и ZFS ACL

параметры ACL NFSv4 в Samba

POSIX 1.E